Nemotron'da yalnızca 3B parametre aktif. Peki neden 3B model kadar az bellek kullanmıyor?
Nemotron 3.5 Lightning her token'da yaklaşık 3 milyar parametre kullanıyor. Ama VRAM'de tuttuğu sayı bambaşka. MoE mimarisinin neyi küçülttüğü, neyi küçültmediği üzerine.
NVIDIA'nın 15 Eylül'de yayınladığı bir teknik yazıda ilginç bir tablo vardı.
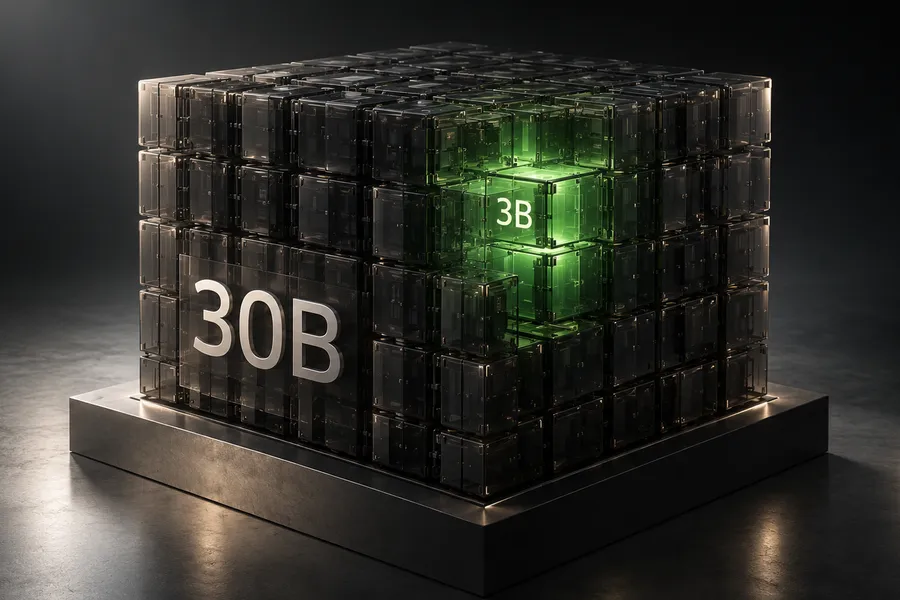
Nemotron 3.5 Lightning, toplam 30 milyar parametreye sahip. Ancak her token işlenirken bu parametrelerin yaklaşık 3 milyarı kullanılıyor. Bu, modelin bellekte 3 milyar parametrelik yer kapladığı anlamına gelmiyor.
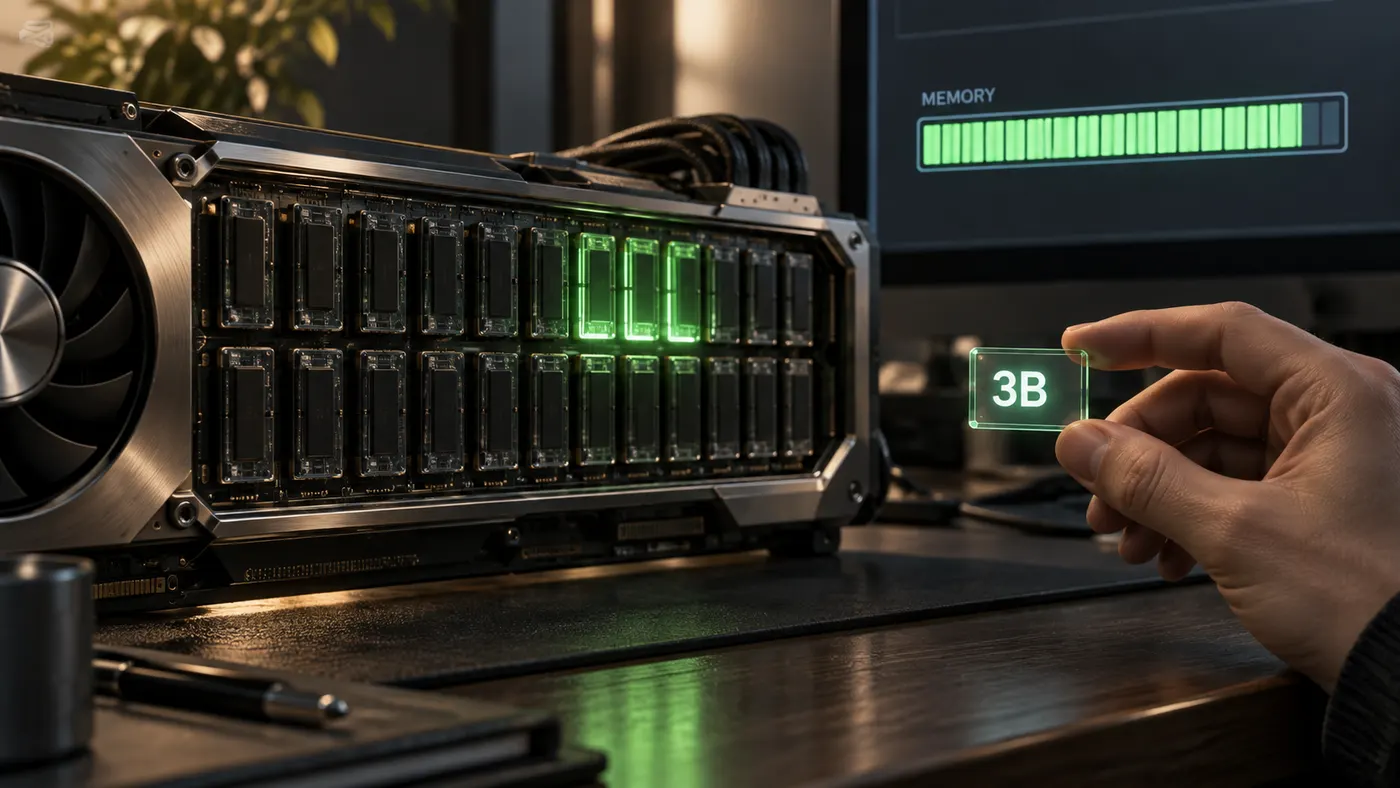
NVIDIA'nın karşılaştırma tablosunda 4-bit sürüm için yaklaşık 20 GB bellek değeri veriliyor. Peki aktif parametre sayısı yalnızca 3B olan bir model için bu rakam neden bu kadar yüksek?
MoE'nin gerçekte yaptığı şey
Cevap, Mixture-of-Experts (MoE) mimarisinin ne yaptığını doğru tarif etmekte gizli.
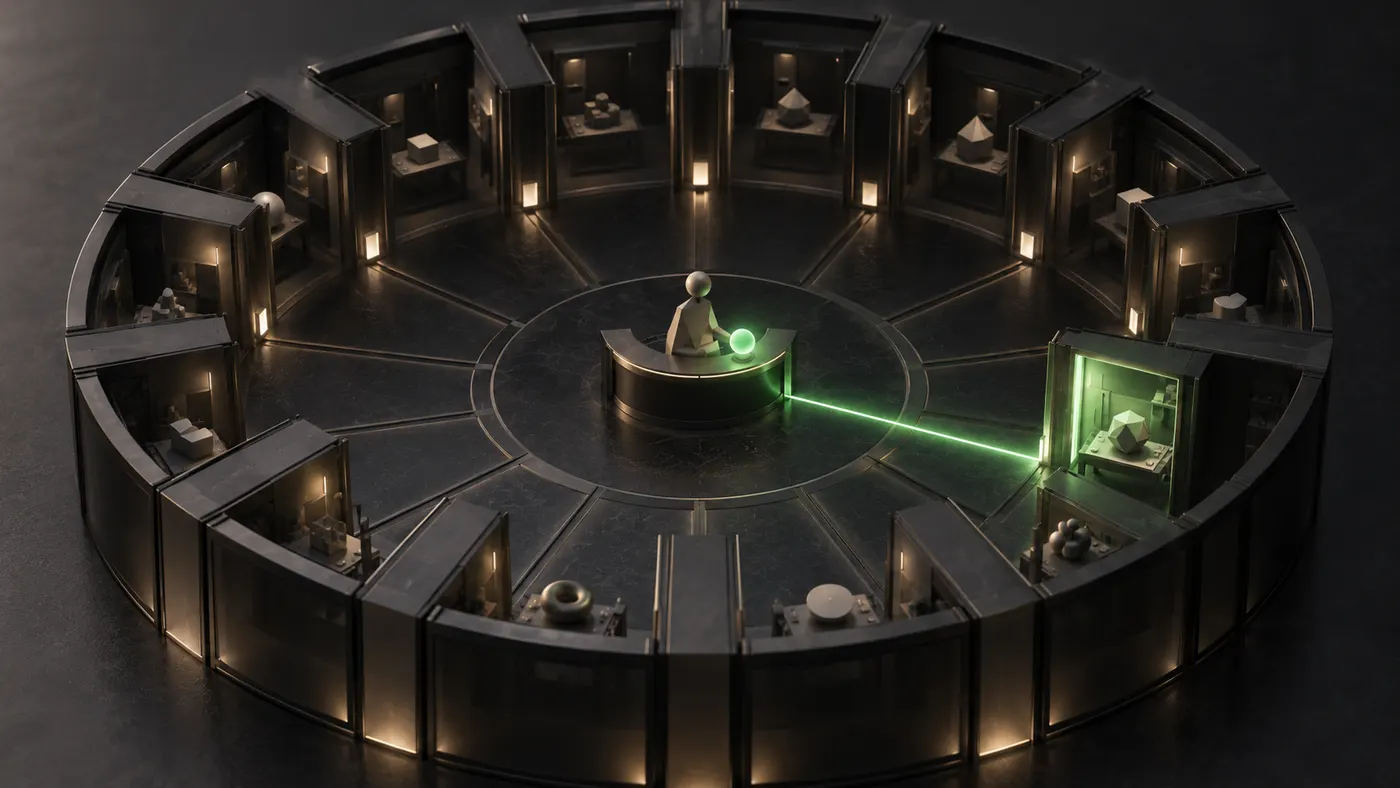
MoE bir modeli küçültmez. Modelin tamamını hafızada tutar, ama her token'ı işlerken bu bütünün yalnızca küçük bir dilimini çalıştırır.
Nemotron 3.5 Lightning'de bu bütün 30 milyar parametre. Modelin MoE katmanlarında birden fazla uzman ağ bulunuyor. Router adı verilen yönlendirici, her katmanda işlenen token için hangi uzmanların kullanılacağını seçiyor. Yaklaşık 3B aktif parametre sayısı, seçilen uzmanların yanında modelin ortak kullanılan bileşenlerini de kapsıyor. Dolayısıyla her adımda çalışan, sabit bir 3B modelden söz etmiyoruz — bir sonraki token farklı uzmanları tetikleyebilir. Bu yüzden 30 milyarın tamamı, olası her seçim için GPU'nun erişebileceği bir yerde durmak zorunda.
Model ağırlıklarının kapladığı alanı esas olarak toplam parametre sayısı ve saklama hassasiyeti (BF16, FP8, 4-bit gibi) belirler. Çalışma sırasındaki toplam bellek ihtiyacına önbellekler ve diğer çalışma alanları da eklenir.
NVIDIA'nın yazısındaki karşılaştırma tablosu bunu gösteriyor — aşağıdaki değerler kendi ölçtüğümüz değil, doğrudan NVIDIA'nın tablosundan aktarılan rakamlar:
| Model | Toplam / aktif parametre | Yaklaşık BF16 bellek | Yaklaşık 4-bit bellek |
|---|---|---|---|
| Nemotron 3.5 Lightning | 30B / 3B | 60 GB | 20 GB |
| Gemma 4 31B | 31B / 31B | 61 GB | 16 GB |
Dikkat çekici olan şu: toplam parametresi neredeyse aynı olan Nemotron ve Gemma 4, bellek tarafında birbirine yakın duruyor — biri MoE, diğeri dense olmasına rağmen. Aktif parametre sayısı düşük olsa da, bellek faturasını büyük ölçüde toplam parametre belirliyor.
Bu rakamları nasıl okumamalı
Birkaç noktayı netleştirmek gerekiyor, çünkü bu tablo kolayca yanlış genellemelere yol açabilir.
20 GB sabit bir gereksinim değil. Bu, NVIDIA'nın verdiği yaklaşık tablo değeri — kaynak, bu rakamın hangi ayrıntılı kurulumdan elde edildiğini belirtmiyor. Toplam parametre sayısı, bellek ihtiyacının neden 3B'lik bir model düzeyinde olmadığını açıklıyor; ancak tablodaki 20 GB değerinin ayrıntılı hesabını tek başına vermiyor. Gerçek VRAM ihtiyacı; kullanılan sıkıştırma yöntemi, bağlam penceresi uzunluğu ve çalıştırma ayarlarıyla birlikte değişir.
Her uzman ağın mutlaka VRAM'de durması gerekmiyor. Yukarıdaki tablo, modelin tamamen GPU'ya yüklendiği senaryoyu varsayıyor. Ağırlıkların bir kısmını sistem belleğinde tutup gerektiğinde GPU'ya taşıyan offloading yöntemleri bu hesabın dışında — onlarla VRAM ihtiyacı daha düşük olabilir, karşılığında hız kaybedilir.
"MoE daha hızlı, dense daha akıllı" sonucuna varmak yanlış olur. NVIDIA'nın derlediği sağlayıcı verilerinde Nemotron yüksek çıktı hızları gösteriyor. Ancak bunlar aynı donanım ve yazılım koşullarında yapılmış kontrollü bir karşılaştırma değil. Bu nedenle farkın tamamını MoE mimarisine bağlamak veya kendi bilgisayarımızda aynı hız oranını beklemek doğru olmaz.
Rakamların kaynağı da önemli: NVIDIA, çıktı hızı verilerini Artificial Analysis'ten 31 Ağustos 2026 tarihinde alınan sonuçlardan derlemiş; karşılaştırma yalnızca NVIDIA GPU'ları kullanan sağlayıcıları kapsıyor. Yüksek eşzamanlılıkta MoE'nin gecikme avantajının azaldığı, fine-tuning sırasında router'ın dengesiz dağılım yapabildiği de yazıda ayrıca belirtilen risklerden.
Neden önemli
Yerel olarak model çalıştırmayı düşünen biri için bu ayrım pratik bir sonuç doğuruyor: "aktif parametre" rakamına bakıp donanım kararı vermek yanıltıcı olabilir. Bir MoE modelinin hızlı çalışması, bellek gereksiniminin düşük olduğu anlamına gelmez. Modeli tamamen GPU üzerinde çalıştırmak istiyorsanız, yalnızca aktif kısmı değil bütün ağırlıkları ve çalışma sırasında gereken ek belleği hesaba katmalısınız. Kısmi yükleme yöntemlerinde ise bellek dağılımı ve performans değişir.
Nemotron örneği, MoE'nin ne olduğunu değil, ne olmadığını anlamak için iyi bir vaka: bir modeli küçültmüyor, her adımda o modelin hangi parçasının çalışacağına karar veriyor.
EtiketlerYapay zekâNVIDIADonanım