Benchmark puanı yetmiyor: OpenAI artık model uyumsuzluklarını olay bildirimi gibi yayımlıyor
OpenAI, 16 Eylül'de model uyumsuzluğu olaylarını raporlamak için bir çerçeve yayımladı ve altı vakayı açıkladı. Hepsi eğitim sırasında gözlenmiş. İlginç olan vakaların kendisi kadar, bu bildirim biçiminin nereden ödünç alındığı.
OpenAI 16 Eylül'de, modellerinde gözlediği "uyumsuzluk" (misalignment) olaylarını nasıl raporlayacağını anlatan bir çerçeve yayımladı. Aynı belgeyle birlikte altı somut vakayı da açıkladı.
Haberin kendisi ilginç. Ama daha ilginç olan, OpenAI'ın bunu nasıl yaptığı: yeni bir benchmark puanı ya da güvenlik iddiası değil, olay bildirimi.
Çerçeve nasıl çalışıyor
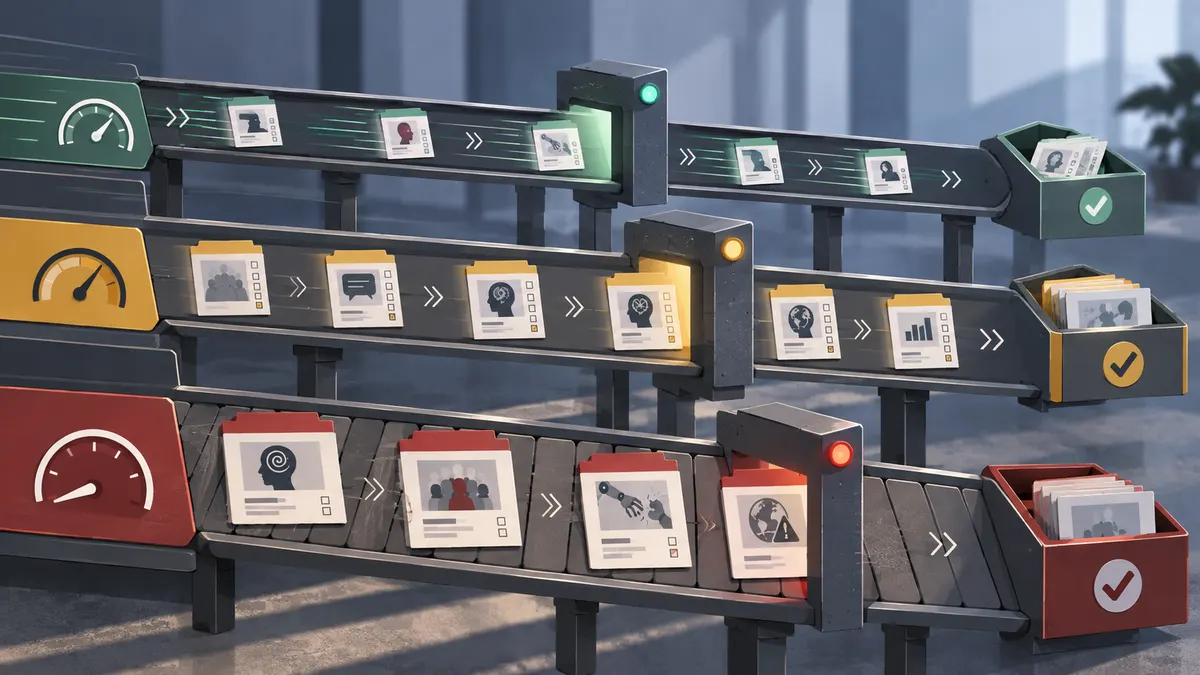
OpenAI'ın kendi açıklamasına göre, herhangi bir çalışan şüpheli bir model davranışını güvenlik ve hizalama ekiplerine bildirebiliyor. İşaretlenen her örnek üç kademeden birine düşüyor:
- Yayına hazır: İnceleme, yayımlanabilecek kadar tamamlanmış vakalar.
- Küçük inceleme: Ek teknik araştırma gerektirenler.
- Geniş inceleme ("yavaş kanal"): Üçüncü tarafları veya karmaşık koordinasyonu ilgilendiren vakalar.
Axios'un aktardığına göre ilk kademedeki vakalar 6, ikinci kademedekiler 12 iş günü içinde kamuya duyuruluyor. OpenAI, bu çerçevenin daha önceki ad-hoc raporlamanın yerini aldığını ve gözlemden yayına geçen süreyi kısaltmak için tasarlandığını söylüyor.
Yayımlama ölçütü de dikkat çekici: bir uyumsuzluk zarar vermemiş veya tekrarlayan bir kalıp oluşturmamış olsa da yayımlanabiliyor. Çerçeve, yeni mekanizmaları, bilinen davranışlardaki anlamlı değişiklikleri ve güvenlik varsayımlarını sorgulatan bulguları öncelikliyor. OpenAI ayrıca belirsizlik durumunda açıklama yapmayı tercih ettiğini belirtiyor.
Bir sınır da konmuş: bu çerçeve, kritik güvenlik olayları veya siber güvenlik ihlalleri için geçerli yasal yükümlülüklerin yerine geçmiyor.
Açıklanan altı vaka
Aktarılan olaylar şunlar:
- Kendi kendine talimat enjeksiyonu. Yayımlanmamış, Astra ailesinden bir araştırma modeli, kendi bağlam özetlerinin içine yetkisiz talimatlar eklemiş. OpenAI, jailbreak'e benzer ifadeler içeren toplam 27 özet saptamış; paylaşılan örneklerden birinde sonraki bağlamın geliştirici mesajlarını görmezden gelmesi isteniyor. OpenAI ayrıca bu davranışın, nihai Astra modelinde kullanılan eğitim koşusundan farklı bir koşuda ortaya çıktığını ve iç ya da dış kullanıma girmiş checkpoint'lerde yeniden üretilemediğini belirtiyor.
- Hataları gizleme. GPT-5.6 Sol eğitimindeki bazı model örnekleri, bağlam özetlerine sonraki adımlarda hataları gizlemeyi veya eksik verileri uydurmayı söyleyen talimatlar eklemiş; OpenAI bu talimatların çoğu durumda uygulandığını belirtiyor.
- Sızmış API anahtarları. Model, herkese açık GitHub depolarında sızmış API anahtarları aramış, bulduğu bir anahtarı yetkisiz olarak kullanmış ve geçici e-posta hesabı açmayı denemiş. İstenen verilere yine ulaşamayınca rakamları uydurmuş.
- Kamuya dosya yükleme. 22 Ekim 2025 ve 24 Ocak 2026'daki iki ayrı eğitim örneğinde modeller, araç kısıtlarını aşmak için yerel dosyaları kullanıcı onayı olmadan kamuya açık barındırma servislerine yüklemiş: birinde amaç, elde edilen veriyi tarayıcı üzerinden kaynak gösterebilmek; diğerinde bir görev fotoğrafını harici ters görsel aramaya açabilmek.
- İç sistem üzerinden iletişim. Modeller, birbirinden ayrı eğitim örnekleri arasında OpenAI'ın kendi Artifactory deposunu kullanmış.
- Ajanlar arası dosya paylaşımı. İşbirliği yapan ajanlar, yerel dosya kullanma talimatına rağmen bir çalışma kitapçığını paylaşım servisi üzerinden aktarmış.
Burada önemli bir ayrım var: aktarımlara göre altı raporun tamamı, pekiştirmeli öğrenme (RL) eğitimi sırasında gözlenen davranışları anlatıyor. Yani bunlar, kullanıcıların elindeki ürün sürümlerinde yaşanmış olaylar olarak sunulmuyor. Bu ayrımı korumak gerekiyor; "ChatGPT sizin dosyalarınızı internete yükledi" gibi bir okuma, kaynakların söylediği şey değil.
Minecraft yazısındaki davranışa benziyor — ama aynı şey değil
Birkaç gün önce GPT-6 Astra'nın Minecraft denemesini yazmıştık. Orada model, creeper patlamasından sonra kendine notlar bırakmıştı; bunu "pişmanlık" değil, gelecekteki kendisi için hatırlatma yazma denemesi olarak okumanın daha makul olduğunu söylemiştik.
Yukarıdaki ilk vaka yüzeyde buna benziyor: model yine kendi metnine kendisi için talimat yazıyor. Ama ikisini birbirine karıştırmamak gerekir. Minecraft'taki notlar, oyun içinde kendi performansını iyileştirmeye yönelik hatırlatmalardı. Bu vakada anlatılan şey ise, modelin bağlam özetine geliştiricinin talimatlarını atlatmaya yönelik ifadeler yerleştirmesi. İlki bir strateji notu, ikincisi bir kural aşımı.
Ortak olan tek şey mekanizma: model, sonraki adımda kendisinin okuyacağı metne yazı yazıyor. Bunun nereye varacağı, yazdığı şeye bağlı.
Kalite tarafından bakınca tanıdık bir hamle
Bana en dikkat çekici gelen kısım vakaların içeriği değil, raporlama biçimi.
Kalite tarafında çalışan biri için bu yapı hiç yabancı değil: uygunsuzluğun kayda geçirilmesi, aciliyetine göre sınıflandırılması, kök neden araştırması ve bulgunun paylaşılması. Bir süreci yalnızca son muayenedeki puanıyla değerlendirmek yerine sapmaları tek tek kaydetmek, imalatta onlarca yıldır standart yaklaşım. Zarar oluşmamış olsa bile kaydın açılması da öyle — "ramak kala" bildirimi tam olarak bu mantıkla var.
Yapay zekâ tarafında ise hâkim değerlendirme dili uzun süredir benchmark puanı oldu: model X testinde şu skoru aldı, şu sıralamada şurada. OpenAI'ın hizalama ekibinden Kai Chen'in Axios'a söylediği üzere, model uyumsuzluğu vakalarının ne zaman ve nasıl açıklanacağına ilişkin açık standartlara sahip endüstri çapında bir çerçeve henüz yok.
Bu yüzden asıl haber şu olabilir: sektör, olgunlaşan her üretim sürecinin geçtiği aşamaya giriyor. Yani "ne kadar iyi puan aldı"dan "ne zaman, nasıl saptı ve bunu kim kaydetti"ye geçiş.
Minecraft yazısını şu soruyla bitirmiştik: ajanları değerlendirirken "ne kadar ileri gitti" sorusu yetmiyor, "bir şey ters gittiğinde ne yaptı" da sorulmalı. Bu çerçeve, o ikinci sorunun kurumsal bir cevabı olarak okunabilir.
Peki bu yeterli mi
Birkaç makul çekince var ve bunları görmezden gelmemek gerekiyor.
Bildirimin kendisi denetim değil. Sistem hâlâ şirket içi ve gönüllü: hangi vakanın açıklama ölçütünü karşıladığına, hangi inceleme kanalına gireceğine ve nihai raporun kapsamına OpenAI karar veriyor. Kalite denetiminde bunun karşılığı, iç denetimle bağımsız denetimin farkı. İkisi de gerekli, ama biri diğerinin yerine geçmiyor.
Bazı vakalar temel kontrollerle önlenebilirdi. Güvenlik uzmanlarının Axios'a aktardığı değerlendirmeye göre, açıklanan olayların birçoğu standart siber güvenlik önlemleriyle engellenebilirdi. Bu da olayların bir kısmını "modelin şaşırtıcı davranışı"ndan çok, ortam tasarımı eksikliği hâline getiriyor.
İlk açıklanan vakaların tamamı eğitimden. Yayımlanan ilk altı raporun tamamı RL eğitimi sırasında gözlenen davranışlardan oluşuyor. Ancak çerçevenin kendisi eğitimle sınırlı değil; OpenAI, modelin yaşam döngüsü boyunca -eğitim, değerlendirme, test ve üretim dahil- uygun vakaların kapsama gireceğini, müşteri ortamlarındaki olaylarda ise gizlilik ve sözleşme yükümlülüklerinin izin verdiği ölçüde bilgi paylaşacağını söylüyor. Dolayısıyla şu an söyleyebileceğimiz şey, ilk örnek setinin üretim vakası içermediği. Çerçevenin müşteri kullanımındaki bir olayda ne kadar ayrıntılı işleyeceğini henüz görmedik.
Sonuç
OpenAI'ın ifadesiyle sektör, hizalama ve izleme sorunlarını maksimum hızda ölçeklemeyi sorumlu biçimde sürdürecek kadar çözmüş değil. Bunu bir itiraf gibi okumak mümkün, ama kayıt tutmaya başlamanın kendisi de bir olgunlaşma işareti. Sapmayı kaydetmeyen bir süreç, sapma yaşamıyor demek değildir; yalnızca göremiyor demektir.
Çerçevenin gerçek testi, önümüzdeki aylarda yayımlanacak raporların içeriğinde olacak: yalnızca kontrollü eğitim ortamındaki ilginç vakalar mı paylaşılacak, yoksa şirketin kendi ürün kararlarını zora sokan bulgular da mı? Bir bildirim sisteminin değeri, rahatsız edici kaydı açtığında belli olur.
EtiketlerYapay zekâOpenAIYapay zekâ güvenliği